Klang
  • 矿业ETF sh561330

    Klang 策略广场
    17
    0 赞同
    17 帖子
    5k 浏览
    A
    当升科技 sz300073[时间:4/2/2024,价格:44.06] 多弗多 sz002407[时间:4/2/2024,价格:15.19]
  • 短线持仓

    技术讨论
    16
    0 赞同
    16 帖子
    4k 浏览
    A
    sz300093[时间:11/24/2023,价格:19.30] 金刚光伏
  • 小米汽车

    Klang 策略广场
    1
    0 赞同
    1 帖子
    905 浏览
    尚无回复
  • 超级好看的模板

    技术讨论
    2
    0 赞同
    2 帖子
    519 浏览
    A
    http://www.mobanwang.com/mb/demo/20958/ 抽象图片
  • 大模型的参数175B是如何算出来的?

    AI研究
    2
    0 赞同
    2 帖子
    2k 浏览
    A
    chatglm-6B: 其次,ChatGLM-6B 的模型架构如下: 解码器层数:48 隐藏层大小:6144 注意力头数:48 注意力头维度:128 嵌入维度:6144 输出维度:50257(词汇表大小) Dropout 比例:0.1 然后,根据这些信息,我们可以计算出 ChatGLM-6B 的各个部分的参数量如下: 解码器自注意力层参数量:(6144∗128+128)∗48∗48=2,260,172,800 解码器前馈网络层参数量:(6144∗6144+6144)∗2∗48=2,865,274,880 解码器总参数量:2,260,172,800+2,865,274,880=5,125,447,680 嵌入层参数量:50257∗6144=308,719,616 输出层参数量:50257∗6144=308,719,616 模型总参数量:5,125,447,680+308,719,616+308,719,616=5,742,886,912 这个结果和 ChatGLM-6B 的论文中给出的结果相符合1。因此,我们可以得出结论,ChatGLM-6B 的参数 6B 是由模型的所有参数的数量得到的。
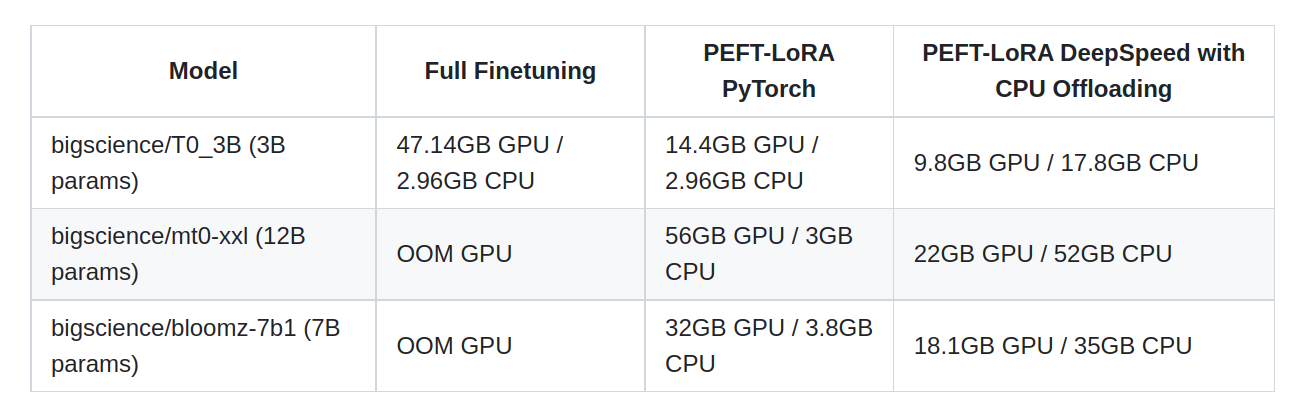
  • 大模型 tuning的几种方法

    AI研究
    1
    0 赞同
    1 帖子
    552 浏览
    尚无回复
  • FinGPTv3.1

    AI研究
    1
    0 赞同
    1 帖子
    738 浏览
    尚无回复
  • 超导板块

    Klang 策略广场
    1
    0 赞同
    1 帖子
    1k 浏览
    尚无回复
  • 一步一步做微调 Finetune

    AI研究
    1
    1
    0 赞同
    1 帖子
    449 浏览
    尚无回复
  • 使用 chatGLM 官方示例做微调

    AI研究
    1
    1
    0 赞同
    1 帖子
    498 浏览
    尚无回复
  • 修复 FinGPT content 爬虫脚本

    AI研究
    2
    0 赞同
    2 帖子
    595 浏览
    A
    FinGPT-v1/data_preparations$ vim download_contents.py
  • 修复 FinNLP 爬虫bug

    AI研究
    1
    0 赞同
    1 帖子
    422 浏览
    尚无回复
  • 如何使用 FinNLP 为 FinGPT准备数据

    AI研究
    1
    0 赞同
    1 帖子
    655 浏览
    尚无回复
  • fingpt 源代码

    AI研究
    3
    0 赞同
    3 帖子
    1k 浏览
    A
    https://ai4finance-foundation.github.io/FinNLP/zh/index_zh/ 中文资料 互联网金融数据 演示内容请参见FinGPT 免责声明:我们根据MIT教育许可证的规定共享代码以供学术研究之用。此处不构成任何金融建议,亦非交易真实资金的推荐。在交易或投资之前请使用常识并首先咨询专业人士。 Ⅰ. 架构 image-20230505200244043 整个项目由4个部分组成: 第一部分是数据源,在这里,我们从互联网上收集历史和流媒体数据。 接下来,我们将数据推送到数据工程部分,在这里我们会对数据进行清洗,标记化处理和提示工程。 然后,数据被推送到大语言模型(LLMs)。在这里,我们可以以不同的方式使用LLMs。我们不仅可以使用收集到的数据来训练我们自己的轻量级微调模型,还可以使用这些数据和训练好的模型或LLM API来支持我们的应用程序。 最后一部分将是应用程序部分,我们可以使用数据和LLMs来制作许多有趣的应用程序。 Ⅱ. 数据源 image-20230505200446477 由于空间限制,我们只展示了其中一部分。 新闻 平台 数据类型 相关市场 指定公司 时间范围 数据源类型 限制条件 文档数量(万) 支持情况 雅虎 金融新闻 美国股票 √ 时间范围 官方 N/A 1,500+ √ 路透社 金融新闻 美国股票 × 时间范围 官方 N/A 1,500+ √ 新浪 金融新闻 中国股票 × 时间范围 官方 N/A 2,000+ √ 东方财富 金融新闻 中国股票 √ 时间范围 官方 N/A 1,000+ √ 第一财经 金融新闻 中国股票 √ 时间范围 官方 N/A 500+ 即将 央视 政府新闻 中国股票 × 时间范围 第三方 N/A 4 √ 美国主流媒体 金融新闻 美国股票 √ 时间范围 第三方 账户 (免费) 3,200+ √ 中国主流媒体 金融新闻 中国股票 × 时间范围 第三方 ¥500/年 3000+ √ FinGPT可能比Bloomberg的文档数目更少,但我们在同一个数量级上。 社交媒体 平台 数据类型 相关市场 指定公司 范围类型 来源类型 限制 文档 (1e4) 支持 Twitter 推文 美国股票 √ 时间范围 官方 N/A 18,000+ √ StockTwits 推文 美国股票 √ 最新 官方 N/A 160,000+ √ Reddit (wallstreetbets) 帖子 美国股票 × 最新 官方 N/A 9+ √ 微博 推文 中国股票 √ 时间范围 官方 Cookies 1,400,000+ √ 微博 推文 中国股票 √ 最新 官方 N/A 1,400,000+ √ 在 BloomberGPT 中,他们不收集社交媒体数据,但我们认为公众舆论是干扰股票市场的最重要因素之一。 公司公告 平台 数据类型 相关市场 指定公司 范围类型 数据来源 限制 文档数 (1e4) 支持情况 巨潮网 (官方) 文本 中国股票 √ 时间范围 官方 N/A 2,790+ √ 美国证监会 (官方) 文本 美国股票 √ 时间范围 官方 N/A 1,440+ √ 由于我们从不同的股票市场收集数据,因此我们比Bloomberg GPT有更多的申报文档。 趋势 平台 数据类型 相关市场 数据源 指定公司 范围类型 源类型 限制 谷歌趋势 指数 美国股票 Google Trends √ 日期范围 官方 N/A 百度指数 指数 中国股票 即将推出 - - - - 数据集 数据源 类型 股票 日期 可用性 AShare 新闻 3680 2018-07-01 到 2021-11-30 √ stocknet-dataset 推文 87 2014-01-02 到 2015-12-30 √ CHRNN 推文 38 2017-01-03 到 2017-12-28 √ Ⅲ. 模型 image-20230505200618504 在数据中心的自然语言处理领域,我们不需要从头开始训练模型。我们只需要调用API和进行轻量级的微调。 左边是一些可能会用到的LLM APIs,中间是我们可能用来进行微调的模型,右边是一些微调方法。 微调:Tensor Layers (LoRA) image-20230505200944411 在FinGPT中,我们使用新的金融数据集对预训练的LLM进行微调。高质量的标记数据是许多成功的LLM(包括ChatGPT)的最重要的关键之一。 然而,这些高质量的标记数据通常非常昂贵和耗时,并且我们可能需要金融专家的帮助。 如果我们的目标是使用LLM分析与金融相关的文本数据并帮助量化交易,为什么不让市场为我们做标记呢? 因此,在这里,我们使用每个新闻相关的股票价格变化百分比作为输出标签,我们使用阈值将标签分成三组(积极的,消极的和中立的),并使用它们和新闻情感的标签。 相应地,在提示工程师部分,我们还要求模型选择其中一个正面的,负面的和中性的作为输出,以便我们充分利用预训练信息。 通过使用LoRA,我们可以将可训练参数减少从6.17B到3.67M。 如表格所示,与chatGLM相比,FinGPT可以在多个指标上实现大幅改善。然而,直接将我们的模型用于量化交易可能是不合适的。由于大多数新闻标题都是中性的,LLMs的大多数原始输出都是中性的,因此LLMs在积极和消极的标签上表现不佳,而这些标签可能对于量化交易是有用的。 然而,在微调之后,我们已经见证了在预测积极和消极标签方面的巨大改进。 这也是为什么该模型可以实现积极的交易结果的原因。 2. 微调:强化学习在股价上的应用 (RLSP) image-20230505201209946 同样地,我们可以使用股价上的强化学习(RLSP)来替换ChatGPT中使用的人类反馈上的强化学习。 Ⅳ. 应用 智能投顾 image-20230505201913233 ChatGPT可以像专业人士一样进行投资建议。 在这个例子中,苹果的股价上涨与ChatGPT分析新闻的预测相符。 2. 量化交易 image-20230505201841001 我们还可以使用新闻、社交媒体推文或者公司公告来构建情感因子,右侧的部分是由Twitter推文和ChatGPT信号产生的交易结果,数据来自于一个称为stocknet-dataset的数据集。 正如您从图片中所看到的,由ChatGPT生成的交易信号非常出色,我们甚至可以仅通过根据Twitter情感因子交易而获得良好的结果。 因此,我们可以通过结合价格因素来获得更好的结果。 3. 低代码开发 image-20230505202028292 我们可以使用LLMs的帮助来编写代码。 右侧显示了我们如何快速高效地开发我们的因子和其他代码。 Made with Material for MkDocs
  • 大飞机板块5.29

    Klang 策略广场
    1
    0 赞同
    1 帖子
    352 浏览
    尚无回复
  • 5.25 新能源板块

    Klang 策略广场
    1
    0 赞同
    1 帖子
    511 浏览
    尚无回复
  • 5.18 机器人板块

    Klang 策略广场
    2
    0 赞同
    2 帖子
    446 浏览
    A
    汇川技术:sz300124[时间:5/18/2023,价格:59.17] 埃斯顿:sz002747[时间:5/18/2023,价格:24.73] 埃夫特:sh688165[时间:5/18/2023,价格:11.12] 赛摩智能:sz300466[时间:5/18/2023,价格:7.07]
  • V字形态 2.28复盘

    技术讨论
    4
    0 赞同
    4 帖子
    1k 浏览
    A
    安徽合力:sh600761[时间:3/27/2023,价格:18.91]
  • 短线策略 3.27

    技术讨论
    1
    0 赞同
    1 帖子
    371 浏览
    尚无回复
  • 股票技术形态-Klang篇

    技术讨论
    1
    0 赞同
    1 帖子
    334 浏览
    尚无回复